Table des matières
SimilityVectorEmbedding
SimilityVectorEmbedding regroupe des carnets Jupyter qui transforment un catalogue de films en vecteurs, puis cherchent des films semblables avec plusieurs méthodes de stockage et de classement. C’est un dépôt AlgoÉTS pour qui veut voir la recherche vectorielle appliquée à de vraies fiches de films. L’article Similarité entre films et recherche vectorielle raconte le même travail, avec les animations de démonstration d’origine.
1. Aperçu
Chaque dossier associe un carnet à la base de données dont il a besoin. Tous lisent un fichier movies.json dont les fiches utilisent des clés en français (titre, annee, genre, realisateur, role, synopsis …) sous films.film.
postgres/0.simple.ipynbest le parcours complet le plus court : il compose un texte par film (titre, année, genres, acteurs, réalisateur, résumé, pays, langue, scénaristes), l’encode avecsentence-transformers/all-MiniLM-L6-v2par mean pooling, normalise les vecteurs et les insère dans une tablemoviesavec une colonneVECTOR(384). Le titre saisi est retrouvé avecpg_trgm, puis la similarité cosinus classe le reste du catalogue. Le carnet calcule aussi la moyenne de plusieurs titres, pondère des titres selon une note, trace les scores et se termine par une interface Gradio.postgres/1.create_table.ipynbencode le même catalogue avec cinq configurations (BART, GTE, MiniLM-L12, RoBERTa et e5-large) et range une colonne de vecteurs par modèle.postgres/3.LLMS.ipynbvectorise une question en langage naturel, lance une requête cosinus pgvector<=>et transmet le schéma de la table à une chaîne LangChain reliée à Ollama (llama2:13b-chat).qdrant/0.simple.ipynbinsère des vecteurs de 384 dimensions par lots de 100 dans une collection cosinus, l’interroge et projette les vecteurs avec t-SNE et k-means.bm25/0.bm25.ipynbclasse les films par mots-clés avecrank_bm25, sans vecteurs.neo4j/1.create_db.ipynbcharge films et personnes sous forme de graphe et note les voisins selon les genres, réalisateurs, scénaristes et acteurs partagés.
2. Cas d’utilisation
Carnets Jupyter qui vectorisent un catalogue de films et trouvent des films proches avec pgvector, Qdrant, BM25, Neo4j et Ollama.
- Vectoriser le catalogue
- ApprenantBase en conteneur
postgres/1.create_table.ipynb compose un texte par film à partir de movies.json et l’encode avec BART, GTE, MiniLM-L12, RoBERTa et e5-large, avec une colonne de vecteurs par modèle.
- Trouver des films proches
- ApprenantBase en conteneur
postgres/0.simple.ipynb retrouve le titre saisi avec pg_trgm, puis classe le catalogue par similarité cosinus pour un titre, plusieurs titres ou des titres notés.
- Chercher dans Gradio
- ApprenantBase en conteneur
Les dernières cellules de postgres/0.simple.ipynb lancent une interface Gradio (modes Single, Multiple et Ratings) qui affiche affiches, années et scores.
- Chercher avec Qdrant
- ApprenantBase en conteneur
qdrant/0.simple.ipynb insère des vecteurs MiniLM de 384 dimensions dans une collection cosinus, l’interroge et projette les vecteurs avec t-SNE et k-means.
- Interroger un LLM local
- ApprenantBase en conteneurLLM local (Ollama)
postgres/3.LLMS.ipynb vectorise une question, lance une requête cosinus pgvector et transmet le schéma à une chaîne LangChain reliée à Ollama llama2:13b-chat.
- Comparer BM25 et graphe Neo4j
- ApprenantBase en conteneur
bm25/0.bm25.ipynb classe les films par mots-clés avec rank_bm25, et neo4j/1.create_db.ipynb les note selon les genres, réalisateurs, scénaristes et acteurs partagés.
2.1. Scénario : Trouver des films proches de The Matrix
- Démarrer PostgreSQL avec pgvector et pg_trgm : cd postgres, puis docker-compose up -d.
- Ouvrir postgres/0.simple.ipynb avec jupyter notebook et exécuter les cellules d’installation et d’import.
- Exécuter main() pour charger movies.json, vectoriser chaque film avec all-MiniLM-L6-v2 et l’insérer dans la table movies.
- Appeler find_similar_movies(conn, cur, "The Matrix") pour obtenir les titres les plus proches au-dessus d’un seuil cosinus de 0,5.
- Tracer le résultat avec plot_similar_movies ou refaire la recherche dans l’interface Gradio.
Fichiers consultésREADME.mdpostgres/README.mdpostgres/docker-compose.ymlpostgres/Dockerfilepostgres/init-db.shpostgres/0.simple.ipynbpostgres/1.create_table.ipynbpostgres/3.LLMS.ipynbqdrant/0.simple.ipynbqdrant/docker-compose.ymlbm25/0.bm25.ipynbneo4j/1.create_db.ipynbneo4j/docker-compose.yml
3. Comment fonctionne la recherche
Les carnets PostgreSQL suivent une même chaîne de traitement. postgres/0.simple.ipynb en est la version la plus lisible ; les étapes ci-dessous le citent.
flowchart LR
  J["movies.json<br/>631 films, clés en français"] --> P["preprocess_movie_data<br/>aplatit rôles, réalisateur, scénaristes"]
  P --> T["Un texte par film<br/>titre année genres acteurs réalisateur<br/>synopsis pays langue scénaristes"]
  T --> E["MiniLM-L6-v2<br/>jetons → moyenne masquée → normalisation L2"]
  E --> DB[("Table PostgreSQL movies<br/>embedding_MiniLM VECTOR(384)")]
  Q["Titre saisi par l’utilisateur"] --> G["similarity() de pg_trgm<br/>meilleur titre si score ≥ 0,3"]
  G --> DB
  DB --> V["Vecteur de requête<br/>un titre, moyenne de titres<br/>ou moyenne pondérée par les notes"]
  V --> C["Similarité cosinus<br/>avec chaque autre film"]
  C --> R["Garder score > 0,5<br/>trier, 10 premiers"]
  R --> UI["Histogramme ou tableau Gradio"]
3.1. 1. D’un enregistrement JSON à un texte
load_movies_data lit films.film dans movies.json ; l’exécution enregistrée charge 631 films. preprocess_movie_data traduit les clés françaises en clés anglaises (titre → title, realisateur.__text → director, scenariste → writers) et extrait les noms d’acteurs de role[].acteur.__text, en plaçant d’abord un rôle isolé dans une liste. generate_embedding assemble ensuite les champs en une chaîne par film, dans cet ordre : titre, année, genres, acteurs, réalisateur, synopsis, pays, langue, scénaristes. Les mots vides anglais de NLTK sont retirés du titre et du synopsis seulement.
3.2. 2. Le plongement
Le modèle est sentence-transformers/all-MiniLM-L6-v2, chargé par AutoModel de Hugging Face. Le tokeniseur tronque chaque texte à 512 jetons et complète le lot par du remplissage. Le modèle renvoie un vecteur de 384 dimensions par jeton ; mean_pooling en fait la moyenne en multipliant par le masque d’attention, pour que les jetons de remplissage ne comptent pas :
token_embeddings = model_output[0]
mask = attention_mask.unsqueeze(-1).expand(token_embeddings.size()).float()
sentence = (token_embeddings * mask).sum(1) / mask.sum(1).clamp(min=1e-9)
F.normalize(..., p=2) ramène ensuite chaque vecteur à une longueur de 1. Après cette étape, similarité cosinus et produit scalaire donnent le même nombre.
3.3. 3. La table
setup_database active les extensions vector, cube et pg_trgm, supprime movies si elle existe et la recrée avec des colonnes simples (titre, acteurs, année, pays, langue, durée, synopsis, réalisateur, affiche), deux tableaux TEXT[] (genre, scénaristes) et embedding_MiniLM VECTOR(384). insert_movie écrit chaque vecteur sous forme de littéral '[0.01, -0.03, …]', que pgvector sait lire. Aucun index HNSW ou IVFFlat n’est créé : chaque recherche compare la requête à toutes les lignes, ce qui reste instantané pour 631 films.
3.4. 4. Trouver le film de départ
Les titres sont saisis approximativement : get_best_matching_title demande donc à pg_trgm le titre le plus proche, avec ORDER BY similarity(title, %s) DESC LIMIT 1. similarity est la part de groupes de trois lettres (trigrammes) que les deux chaînes ont en commun, de 0 à 1. Si le meilleur score est sous 0,3, la recherche s’arrête sur « No close match found ». Sinon, le carnet relit le vecteur enregistré de ce film.
3.5. 5. Score et classement
find_similar_movies charge le vecteur de chaque autre film et calcule cosine_similarity(query, embeddings) avec scikit-learn, en Python. Un film est retenu si son score dépasse 0,5, et les dix premiers sont renvoyés par ordre décroissant. Les deux variantes ne changent que le vecteur de requête :
- Plusieurs titres (
find_similar_movies_list) : la moyenne simple des vecteurs des titres ; une trilogie oriente donc la recherche vers ce que les trois films partagent. - Titres notés (
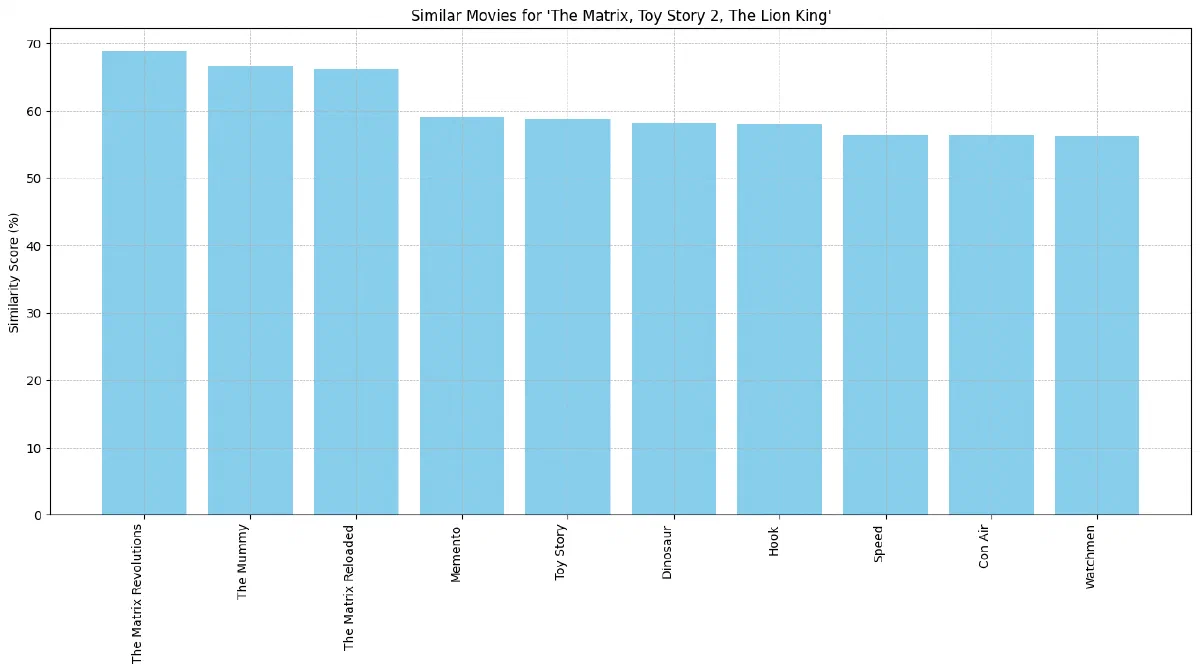
find_similar_movies_ratings) : une moyenne pondérée. Le film placé àinfluential_indexreçoit le poids(note − 1) × influence_factor; les autres gardent leur note comme poids. Dans l’exemple du carnet, The Matrix, Toy Story 2 et The Lion King notés 100, 100 et 1, les poids valent 198, 100 et 1 : la requête est faite aux deux tiers de The Matrix, au tiers de Toy Story 2 et presque pas de The Lion King.
Les autres carnets font la même comparaison dans la base. 3.LLMS.ipynb trie sur 1 - (embedding_MiniLM <=> query) : l’opérateur <=> de pgvector renvoie la distance cosinus, donc un moins cette valeur donne la similarité. 2.analyse.ipynb essaie aussi <-> (euclidienne), <#> (produit scalaire négatif) et <+> (L1).
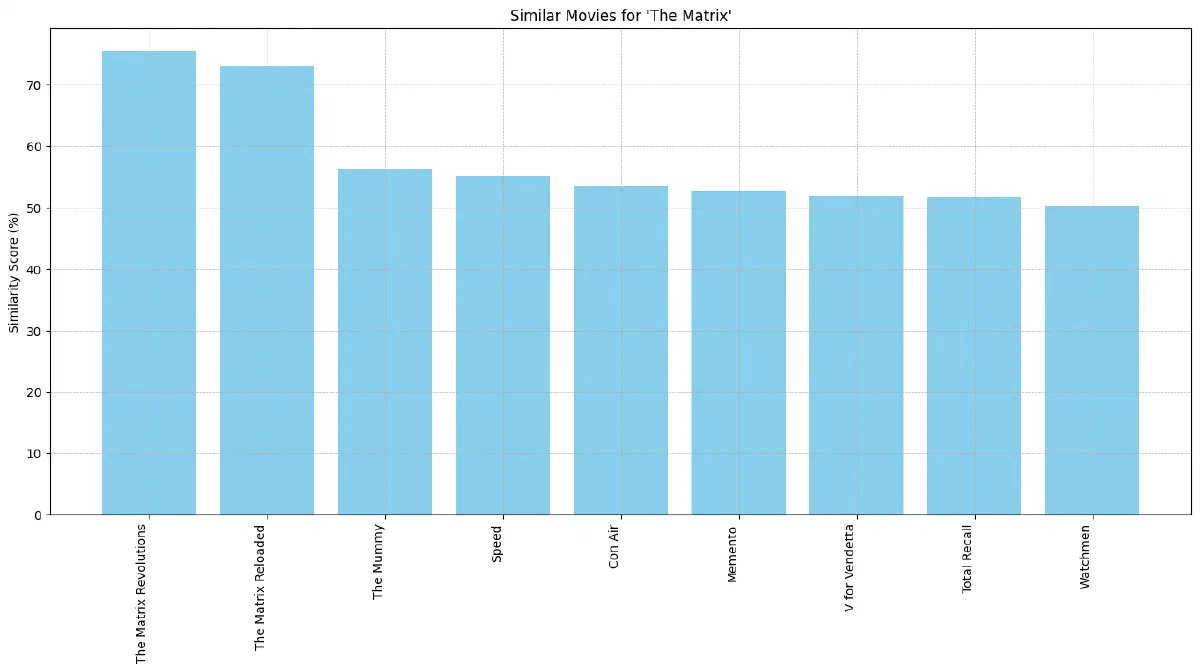
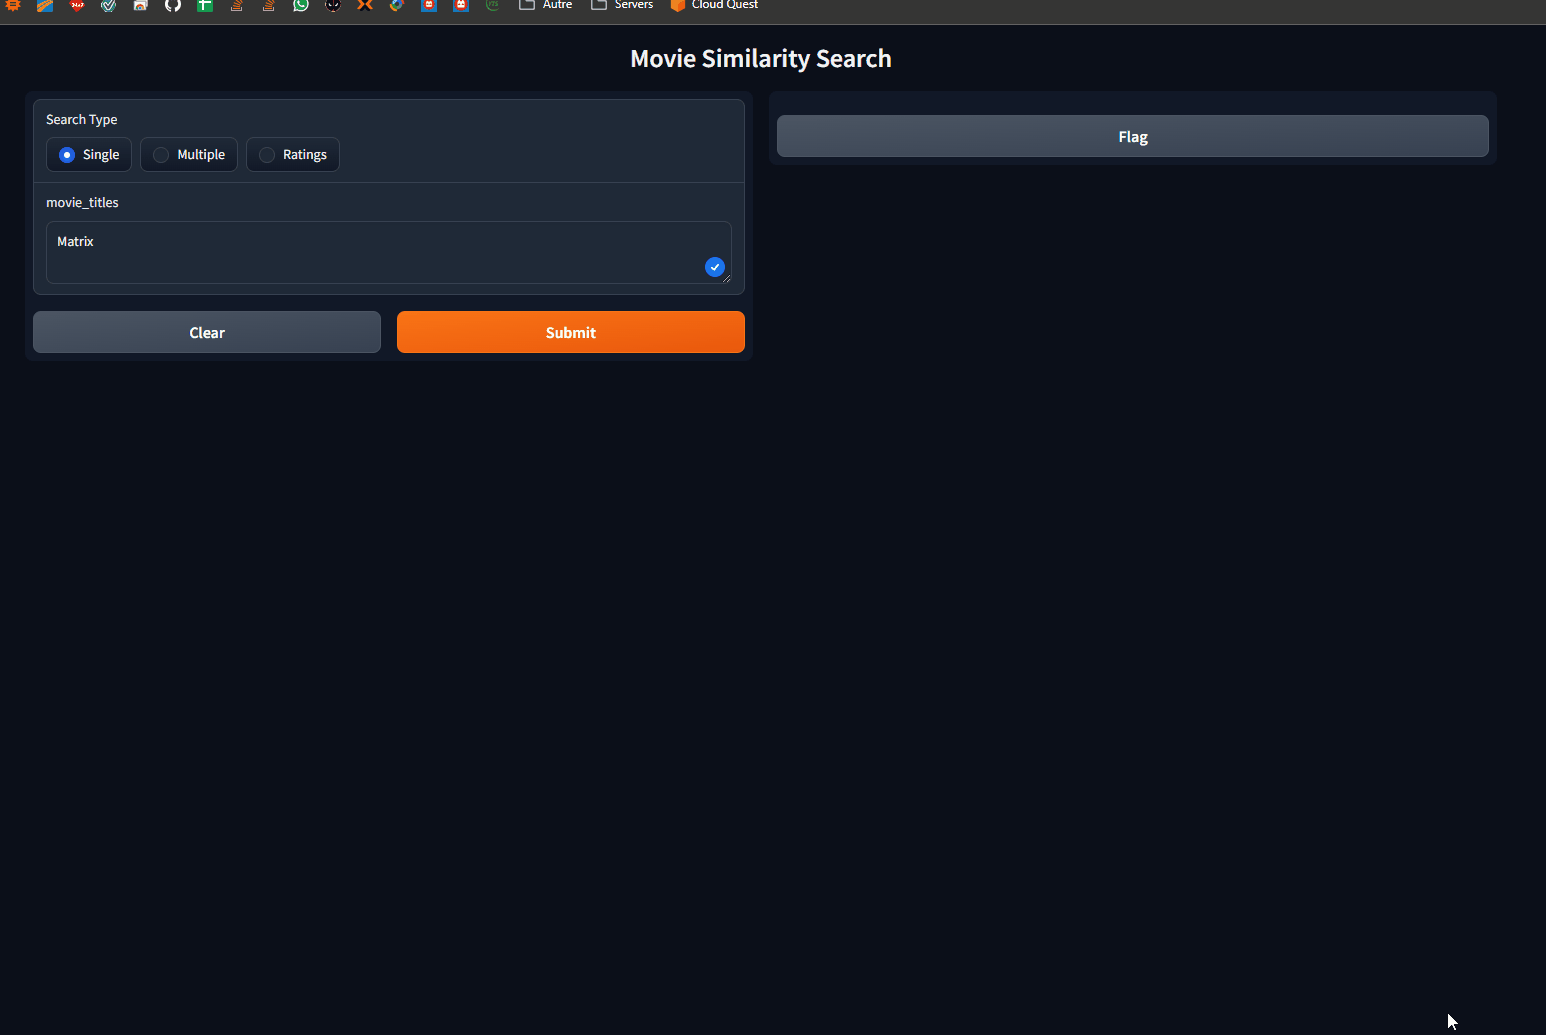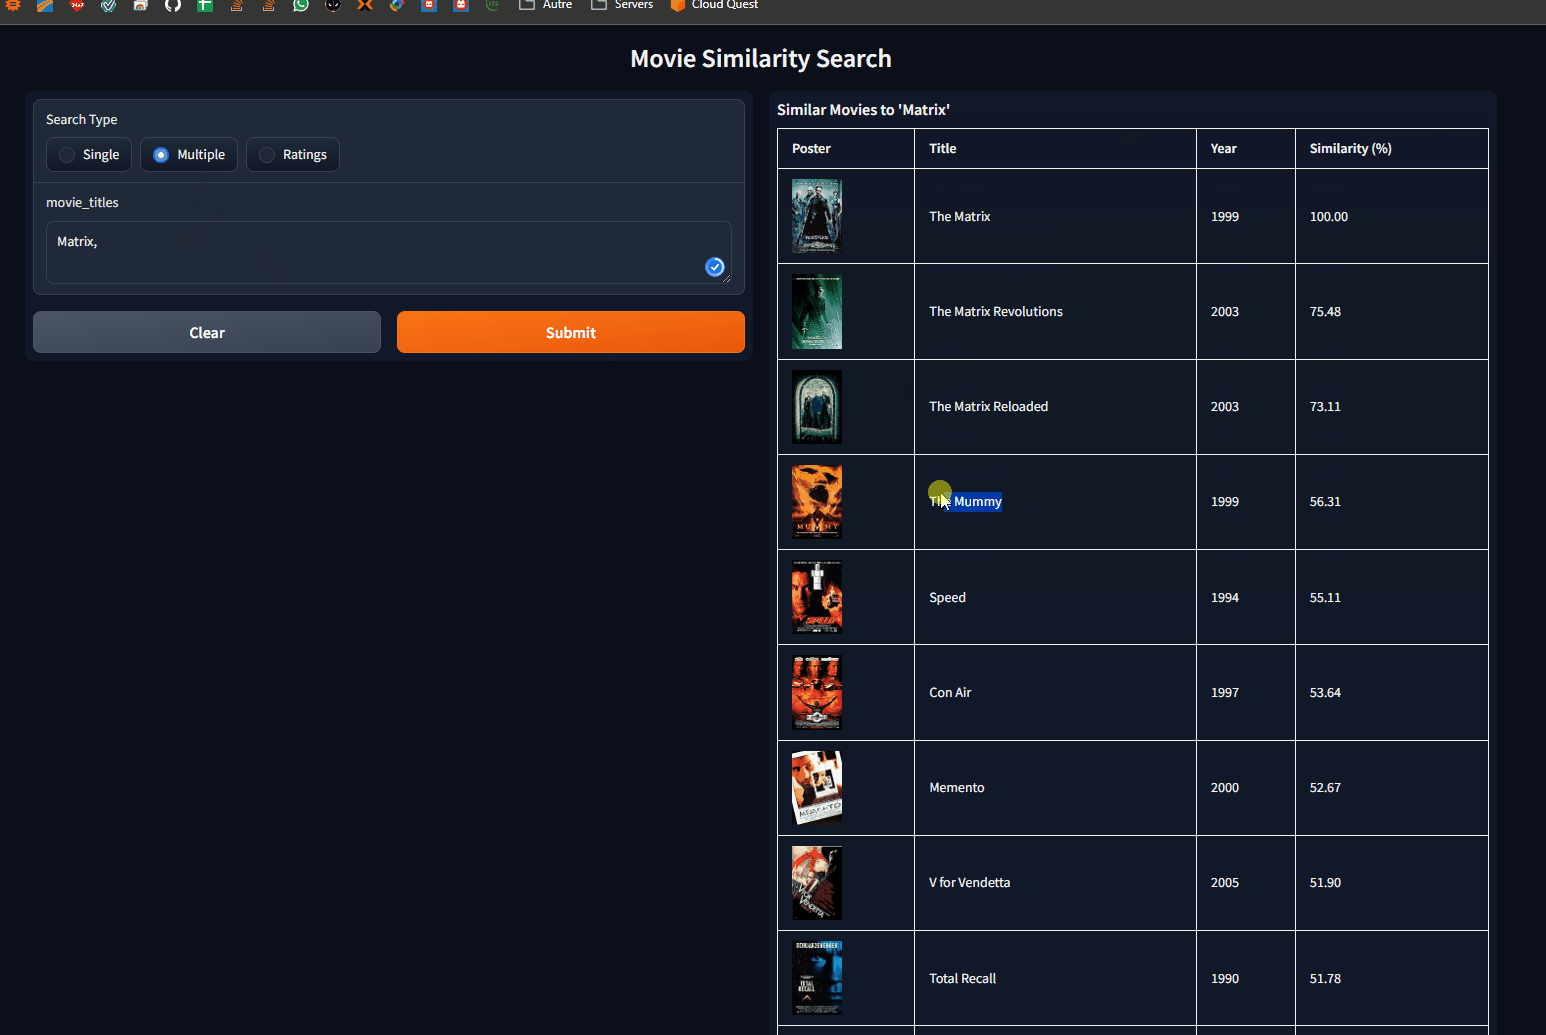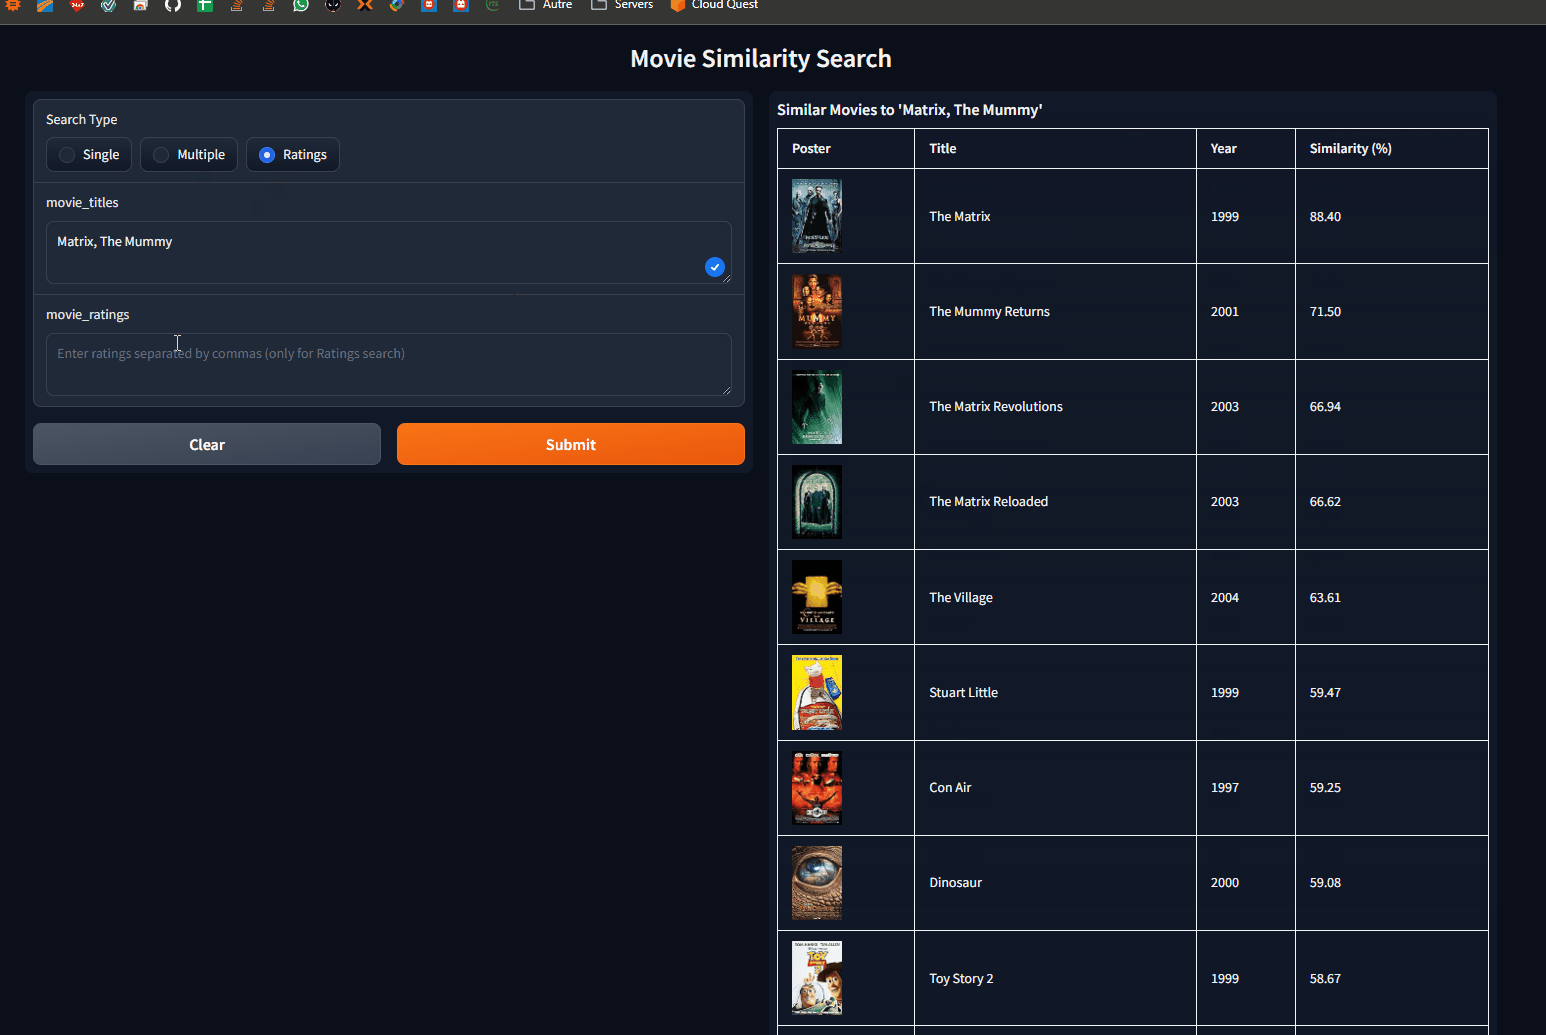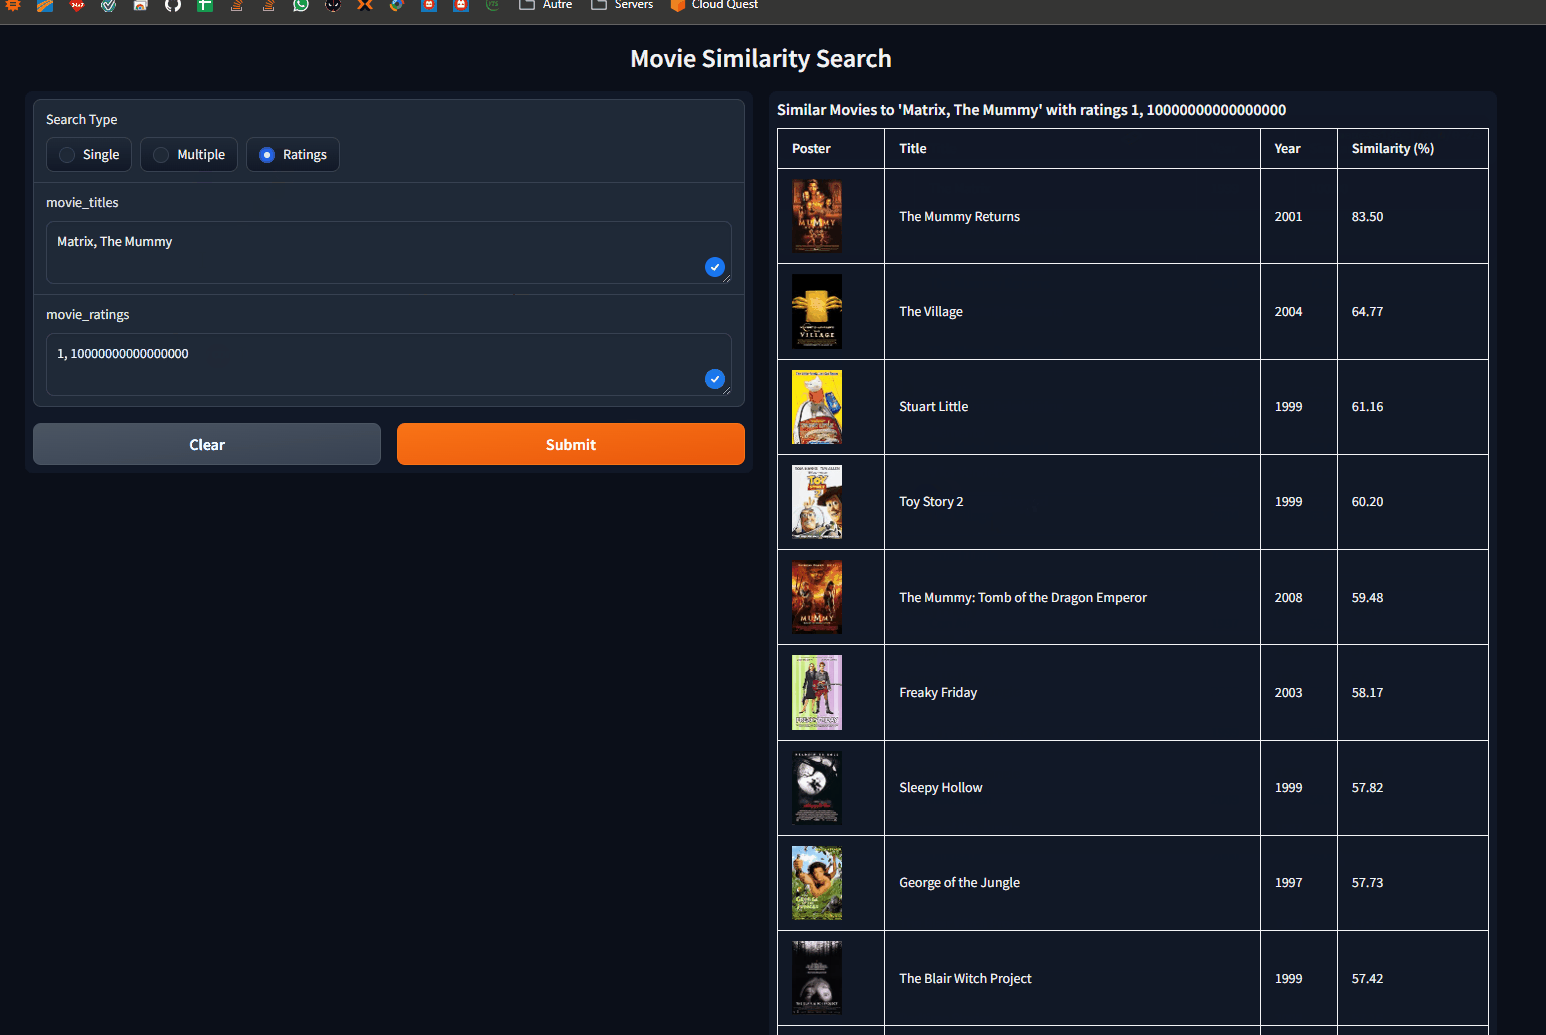
find_similar_movies pour The Matrix : les deux suites obtiennent environ 75 % et 73 %, puis The Mummy, Speed et Con Air autour de 55 %. Neuf films passent le seuil de 0,5.
3.6. 6. Choisir un modèle
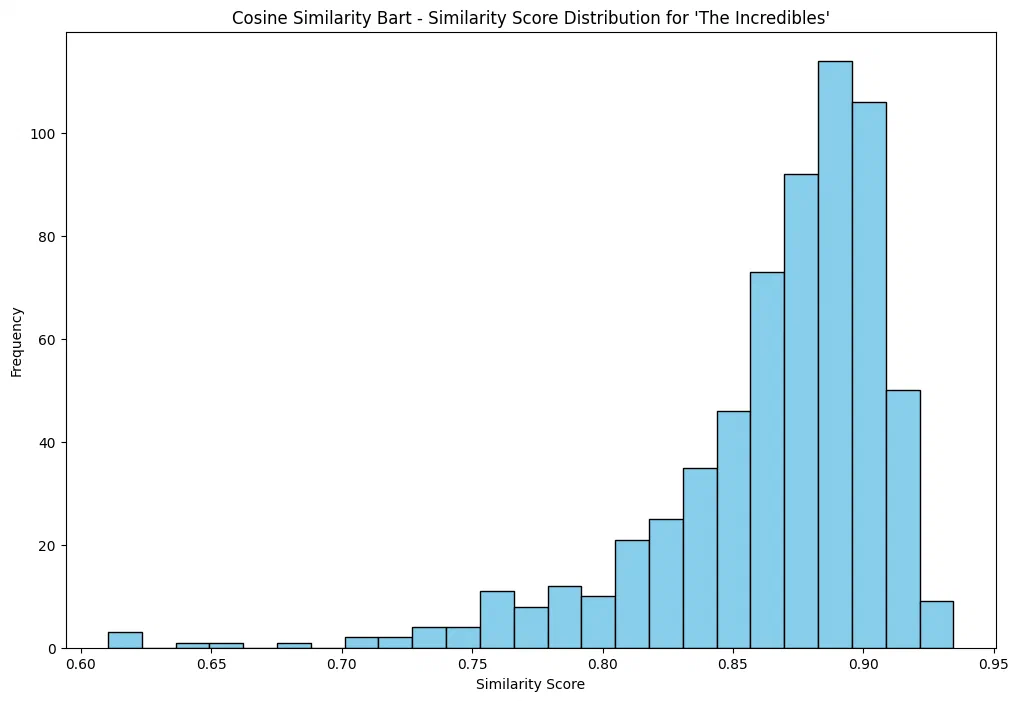
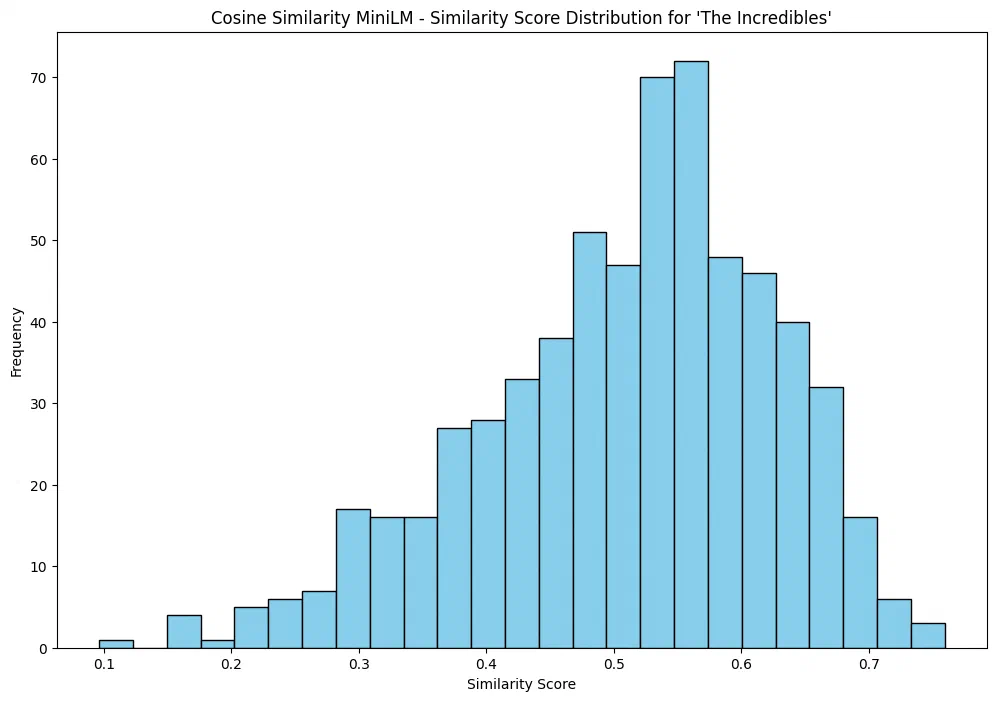
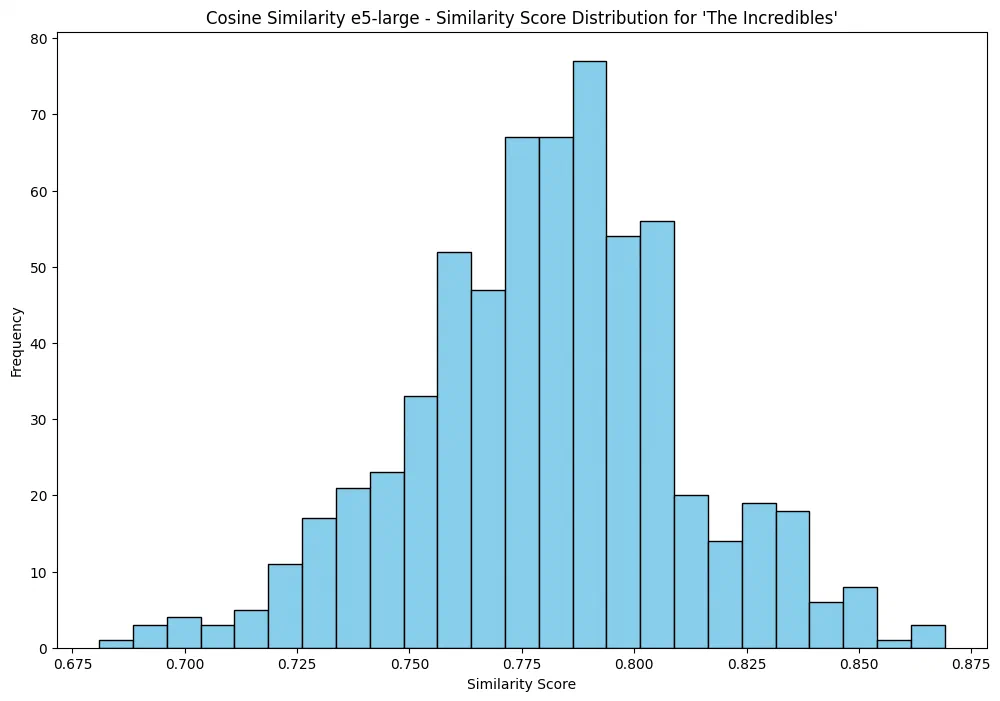
1.create_table.ipynb enregistre cinq plongements par film côte à côte : facebook/bart-large, Alibaba-NLP/gte-large-en-v1.5 et intfloat/e5-large par AutoModel (1 024 dimensions), puis all-MiniLM-L12-v2 (384) et nli-roberta-large (1 024) par SentenceTransformer. 2.analyse.ipynb trace ensuite, pour un film de départ, le score cosinus de tous les autres films du catalogue. L’étalement des scores compte plus que leur niveau : un modèle dont tous les scores tiennent dans une bande étroite ne peut pas séparer un film proche d’un film sans rapport avec un seuil fixe.
3.7. 7. Regarder l’espace
Le carnet Qdrant range les mêmes vecteurs MiniLM de 384 dimensions dans une collection cosinus, puis les projette en deux dimensions avec t-SNE et les regroupe avec k-means. La projection n’est qu’une image : les distances d’un graphique t-SNE ne sont pas les scores cosinus utilisés pour la recherche.
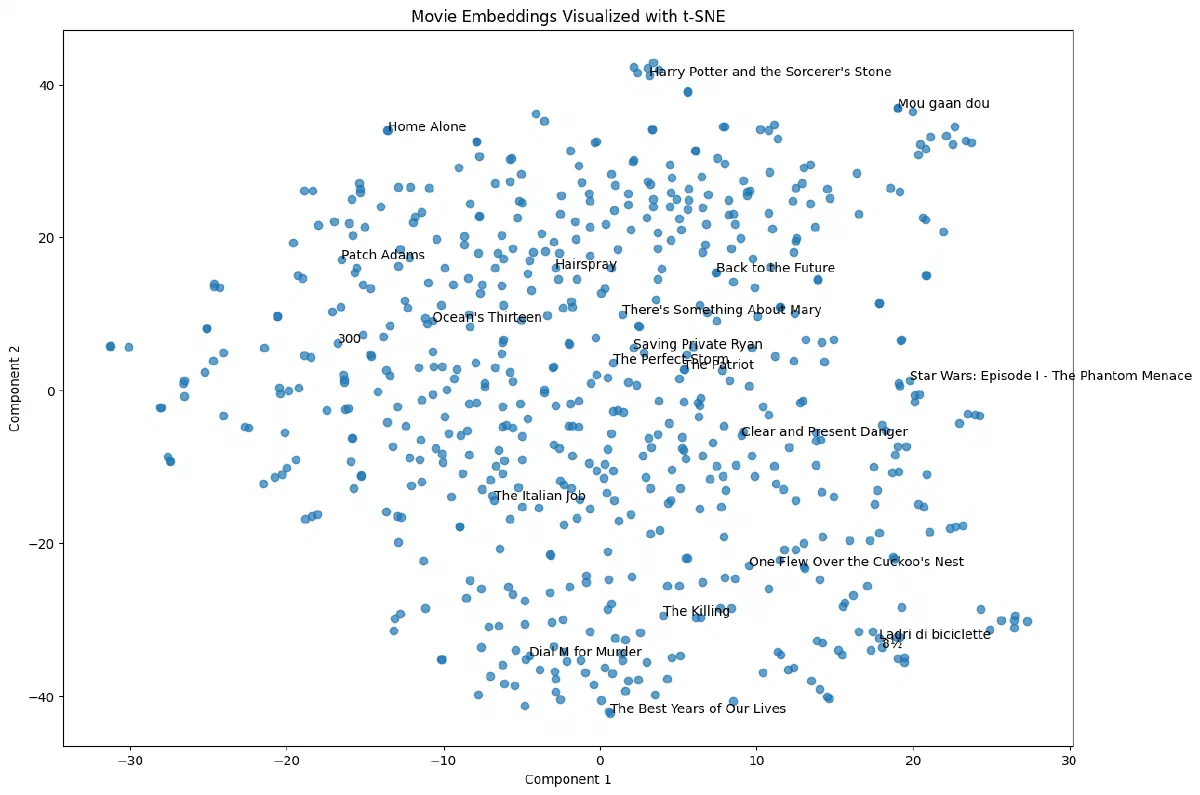
qdrant/0.simple.ipynb.
La cellule Gradio réunit les trois recherches dans une page qui affiche affiches, titres, années et scores. Cet enregistrement vient de l’article associé.
4. Démarrage
Les carnets installent leurs paquets avec des cellules !pip install. Démarrez la base du carnet voulu, puis ouvrez Jupyter :
git clone https://github.com/AlgoETS/SimilityVectorEmbedding.git
cd SimilityVectorEmbedding/postgres
docker-compose up -d
jupyter notebook
postgres/docker-compose.yml construit PostgreSQL avec pgvector compilé depuis les sources et pg_trgm, sur le port 5432. Les dossiers qdrant/ et neo4j/ ont chacun leur docker-compose.yml (Qdrant sur 6333/6334, Neo4j sur 7474/7687 avec APOC et Graph Data Science). neo4j/install_ollama.sh installe Ollama sous Linux pour le carnet LLM.
5. Guide du dépôt
postgres/0.simple.ipynb: vecteurs MiniLM, correspondance de titres, recherches simple, multiple ou pondérée, graphique en barres et interface Gradio.postgres/1.create_table.ipynb: cinq modèles de vectorisation rangés côte à côte dans PostgreSQL.postgres/2.analyse.ipynb: distributions des scores par modèle et comparaison des scores cosinus, euclidien, produit scalaire, Hamming et Jaccard.postgres/3.LLMS.ipynb: vectorisation de la question, requête pgvector et invite LangChain + Ollama.postgres/pgvector-archive.ipynb: une version antérieure, tout-en-un, du carnet d’analyse.postgres/Dockerfile,postgres/docker-compose.yml,postgres/init-db.sh: image de la base et activation des extensions.qdrant/0.simple.ipynb,qdrant/docker-compose.yml: la version Qdrant de la recherche, avec graphiques de regroupement.bm25/0.bm25.ipynb: point de comparaison par mots-clés.neo4j/1.create_db.ipynb,neo4j/docker-compose.yml,neo4j/personnes.json: modèle en graphe des films et des personnes.*/movies.json: le catalogue de films, copié dans chaque dossier.
6. Fonctionnalités
- composer le texte à vectoriser à partir de plusieurs champs, en retirant les mots vides anglais du titre et du résumé ;
- comparer cinq modèles Hugging Face / Sentence Transformers sur le même catalogue ;
- stocker les vecteurs dans PostgreSQL avec pgvector et retrouver des titres approximatifs avec
pg_trgm; - chercher à partir d’un titre, de la moyenne de plusieurs titres ou d’un mélange pondéré par des notes ;
- reprendre la même idée avec Qdrant, puis avec BM25 et un graphe Neo4j pour comparer ;
- poser des questions à un LLM local appuyé sur la table
movies; - lire les résultats en graphiques à barres, projections t-SNE/k-means, vues de graphe et page Gradio.
7. Limites
- Le README demande
pip install -r requirements.txtet un carnetSimilarity_Vector_Embedding.ipynb; aucun des deux fichiers n’est dans le dépôt. Les dépendances viennent des cellules!pip install. - Le schéma du README montre une seule colonne
VECTOR(768); les carnets créent une colonne par modèle (384 ou 1024 dimensions). postgres/init-db.shcrée une extension nomméepgvector, alors que les carnets créentvector, le nom enregistré par pgvector.- Les carnets suppriment puis recréent la table
movieset la collection Qdrant, et utilisent des identifiants locaux codés en dur (postgres/postgres,neo4j/password). - Le carnet LLM exige un serveur Ollama avec
llama2:13b-chat; la cellule Gradio appellelaunch(share=True), qui ouvre un lien de partage public. - Dans
1.create_table.ipynb, les vecteurs BART, GTE et e5 valentlast_hidden_state.mean(dim=1): la moyenne inclut les jetons de remplissage, contrairement à la moyenne masquée du carnet simple, et les synopsis courts sont dilués. La fiche du modèle e5 demande aussi un préfixepassage:que le carnet n’ajoute pas. - La recherche exclut les titres tels qu’ils ont été saisis, mais cherche le titre trouvé par correspondance approximative. Saisir « the matrix » en minuscules peut renvoyer The Matrix comme son propre meilleur résultat.
0.simple.ipynbrécupère tous les vecteurs et les note en Python ; seuls les carnets d’analyse et de LLM confient le classement à pgvector. Aucun index vectoriel n’est construit.- Il n’y a pas de tests. Les sorties enregistrées dans les carnets montrent des exécutions passées, pas des mesures de performance.
8. Sources
- Dépôt GitHub
- README
postgres/0.simple.ipynbpostgres/1.create_table.ipynbpostgres/2.analyse.ipynbpostgres/3.LLMS.ipynb- Article associé : Similarité entre films et recherche vectorielle
qdrant/0.simple.ipynbneo4j/1.create_db.ipynb
9. Pipeline CI/CD
Aucun pipeline CI/CD dans le dépôt. Le code se construit et se lance à la main, comme décrit plus haut.
Généré à partir du code au commit f3db032.
10. Schéma de déploiement
Mermaid Schéma de déploiement
flowchart LR
  repo[("Dépôt GitHub")]
  image["Image Docker<br/>FROM postgres:latest"]
  subgraph compose["Docker Compose"]
    svc_neo4j["neo4j"]
    svc_pgvector["pgvector"]
    svc_qdrant["qdrant"]
  end
  repo -->|"docker build"| image
  image -->|"docker compose up"| compose
11. Dépendances externes
Le dépôt ne déclare aucun paquet externe : aucun manifeste (pyproject.toml, requirements.txt, package.json, pom.xml…) n’y figure.
12. Glossaire
Dépôt
Les fichiers source, la configuration et l’historique versionné d’un projet.
README
Le document d’entrée du dépôt, qui présente généralement son rôle et son installation.
Dépendance
Une bibliothèque, un outil ou un service nécessaire à la compilation ou à l’exécution d’un composant.
HTTP
Un protocole de requête et réponse utilisé par les navigateurs et services web. Une requête comprend une méthode, un chemin, des en-têtes et parfois un corps.
Conteneur
Un environnement de processus isolé créé à partir d’une image. Les données persistantes nécessitent un stockage hors de son système de fichiers temporaire.
Docker Compose
Un format de configuration et un outil pour lancer des conteneurs, réseaux et volumes associés. L’ordre de démarrage ne garantit pas qu’un service est prêt.
Volume et montage de dossier
Un volume est un stockage géré par la plateforme de conteneurs ; un montage de dossier expose un chemin de l’hôte dans un conteneur.
Port publié
Un port de l’hôte associé au port d’un service dans un conteneur. Sa publication peut rendre le service accessible hors du réseau des conteneurs.
Interface en ligne de commande
Une interface textuelle où les commandes et arguments choisissent les opérations. Les codes de retour permettent aux scripts de détecter un succès ou un échec.
Compilation
Les étapes qui transforment les sources et dépendances en programme exécutable ou en livrable distribuable.
Intégration continue
Des vérifications automatiques lors des changements de source, comme la compilation, les tests et l’analyse statique. Elles ne couvrent que ce qu’elles vérifient.
Mermaid
Un langage de diagrammes textuel. Les nœuds et liens décrivent un modèle ; le diagramme n’exécute pas le projet.
Base de données
Un système de stockage et d’interrogation de données structurées. Son schéma, ses règles d’accès et sa persistance déterminent comment l’application utilise ces données.
13. Références
- AlgoÉTS. (2026, 5 novembre). [Web page] github.com.
- AlgoETS. (2026, 5 novembre). SimilityVectorEmbedding. [Software repository] github.com.
- AlgoETS. (2026, 5 novembre). README. [Source file or documentation] github.com.
- AlgoETS. (2026, 5 novembre). postgres/0.simple.ipynb. [Source file or documentation] github.com.
- AlgoETS. (2026, 5 novembre). postgres/1.create_table.ipynb. [Source file or documentation] github.com.
- AlgoETS. (2026, 5 novembre). postgres/2.analyse.ipynb. [Source file or documentation] github.com.
- AlgoETS. (2026, 5 novembre). postgres/3.LLMS.ipynb. [Source file or documentation] github.com.
- AlgoETS. (2026, 5 novembre). qdrant/0.simple.ipynb. [Source file or documentation] github.com.
- AlgoETS. (2026, 5 novembre). neo4j/1.create_db.ipynb. [Source file or documentation] github.com.
Les sources sans date de publication indiquent la date de leur dernière vérification, le 5 novembre 2026. Les liens des fichiers conservent la révision inspectée lorsqu’elle est disponible.