LLM2SVG : Analyser les données avant de parler de modèle
Ce fork LLM2SVG contient des outils de données SVG et une structure d’évaluation. L’implémentation permet d’examiner exemples et contraintes, sans démontrer un modèle texte-vers-SVG terminé ou entraîné.
Langages du dépôtPython 100%1
Parts calculées à partir des octets GitHub Linguist.
| Langage | % | Octets |
|---|---|---|
| Python | 49 062 |
Aperçu
Pourquoi il existe
Générateur et validateur Python d'illustrations vectorielles SVG à partir de descriptions en langage naturel.
Cas d’usage
Génération automatisée d'icônes et d'illustrations vectorielles pour systèmes de design.
Démarrage
Ces commandes viennent de la documentation du dépôt. Elles n’ont pas été exécutées pendant cette revue.
pip install cairosvg torch torchvisionRéférences du dépôt
Extraits des guides du dépôt, dans leur langue d’origine. Les liens ouvrent la version du code consultée.
Prérequis et premier essai
Submission Requirements
README.md
Fonctions et composants 2
- Chargement et contraintes
- SVGAnalyzer utilise SVGDataLoader et SVGConstraints. Il énumère les exemples, relève les tailles et vérifie les contraintes. Le chargement et la validation constituent des responsabilités distinctes.
- Rapports sur les données
- L’analyseur compte les noms d’éléments et conserve des résultats de validation par exemple. Sa méthode de résumé retourne un DataFrame pandas. Le comptage utilise une expression régulière pour tolérer du SVG mal formé.
Architecture
Les composants et leurs liens restent lisibles en texte. Le diagramme ajoute une vue interactive.
- Fichiers du jeu de données
- SVGDataLoader
- Analyse des éléments et tailles
- Vérifications des contraintes
- Rapport de données
Liens vérifiés dans le dépôt.
Mermaid Diagramme interactif (chargement à l’ouverture)
Vue générale des composants et des échanges vérifiés dans le dépôt.
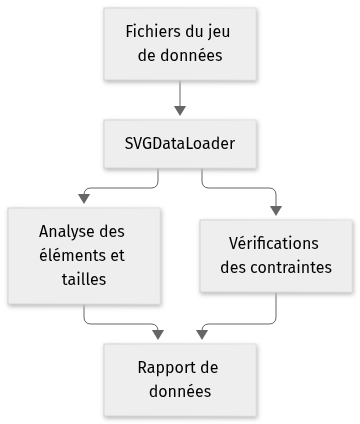
flowchart LR
  n0["Fichiers du jeu de données"]
  n1["SVGDataLoader"]
  n2["Analyse des éléments et tailles"]
  n3["Vérifications des contraintes"]
  n4["Rapport de données"]
  n0 --> n1
  n1 --> n2
  n1 --> n3
  n2 --> n4
  n3 --> n4
Version texte du diagramme
- Fichiers du jeu de données → SVGDataLoader
- SVGDataLoader → Analyse des éléments et tailles
- SVGDataLoader → Vérifications des contraintes
- Analyse des éléments et tailles → Rapport de données
- Vérifications des contraintes → Rapport de données
Suivre un parcours dans le code
Suivez validate_all_svgs et comparez-le à analyze_elements. Respecter les contraintes et posséder des noms d’éléments plausibles sont deux vérifications différentes; aucune ne prouve la ressemblance visuelle avec une consigne.
Types et structure des fichiers
5 types déclarés, dont 5 dans l’aperçu des relations de base.
Diagramme des types
classDiagram
direction TB
class t61fa9a7ee491["SVGDataLoader"] {
  __init__()
  get_train_descriptions()
  get_test_descriptions()
  _load_descriptions()
}
class t30b1f34dc117["SVGAnalyzer"] {
  __init__()
  count_svgs()
  get_svg_sizes()
  analyze_elements()
}
class td0970883b50c["SVGConstraints"] {
  validate_svg()
}
class tae5163df548f["SVGDataset"] {
  __init__()
  __len__()
  __getitem__()
}
class t7bf894fe8630["TextParser"] {
  __init__()
  extract_colors()
  extract_shapes()
  extract_patterns()
}
class b4e2a6e40a537["Dataset"] {
  <<unresolved_base>>
}
b4e2a6e40a537 <|-- tae5163df548f
Les bases non résolues restent identifiées; les signatures complètes ne sont pas reconstruites.
Index des types
SVGDataLoader(class) ·utils/data_loader.py:7Méthodes dans l’aperçu :
__init__, get_train_descriptions, get_test_descriptions, _load_descriptions.SVGAnalyzer(class) ·utils/svg_analyzer.py:13Méthodes dans l’aperçu :
__init__, count_svgs, get_svg_sizes, analyze_elements.SVGConstraints(class) ·utils/svg_constraints.py:7Méthodes dans l’aperçu :
validate_svg.SVGDataset(class) ·utils/svg_dataset.py:9Méthodes dans l’aperçu :
__init__, __len__, __getitem__.Bases déclarées :
Dataset.TextParser(class) ·utils/text_parser.py:4Méthodes dans l’aperçu :
__init__, extract_colors, extract_shapes, extract_patterns.
Référence
8 / 8 fichiers admissibles lus (286 dans l’arbre); 0 trop volumineux, 0 échec de lecture et 0 diagnostic de syntaxe.
Ce que couvre l’analyse
Les dossiers connus de dépendances et de compilation, les fichiers d’identifiants et les binaires sont exclus. La collecte couvre les README, les manifestes reconnus et les fichiers source pris en charge.
Les statistiques Linguist couvrent l’ensemble du dépôt et peuvent inclure d’autres langages.
Carte des fichiers
flowchart TD
  root["LLM2SVG"]
  f0["utils/data_loader.py"]
  root --> f0
  f1["utils/svg_analyzer.py"]
  root --> f1
  f2["utils/svg_constraints.py"]
  root --> f2
  f3["README.md"]
  root --> f3
  f4["utils/__init__.py"]
  root --> f4
  f5["utils/svg_dataset.py"]
  root --> f5
  f6["utils/svg_utils.py"]
  root --> f6
  f7["utils/text_parser.py"]
  root --> f7