Aller au contenu
← Tous les articles
Article

Enseigner Python avec un atelier de données de bout en bout

Écouter en version balado

De l'installation au graphique boursier en neuf notebooks · 2:29 · voix synthétiques, script rédigé avec l’IA

Transcription

Sylvie : Imagine quelqu'un qui découvre Python. À la fin de l'atelier, il trace le cours d'Apple avec cinq courbes de moyennes mobiles. Comment on l'amène jusque-là ?

Thierry : Ça semble un grand saut. D'habitude, on perd les gens dès l'installation.

Sylvie : C'est justement ce que l'atelier Workshop1 d'AlgoETS évite. C'est un dépôt GitHub de neuf notebooks Jupyter, rangés dans six dossiers numérotés. Chaque notion sert à construire la suivante.

Thierry : Donc plutôt un escalier qu'un tas de leçons.

Sylvie : Oui. On commence par l'environnement, puis les bases de Python et les notions plus avancées, ensuite la lecture d'une réponse d'API, puis pandas pour explorer et nettoyer les données, deux notebooks de visualisation, et enfin un projet final.

Thierry : Et l'installation, justement ?

Sylvie : Le README propose un lien Colab : on code dans le navigateur dès le début. L'installation Jupyter locale est documentée aussi. La configuration reste un sujet à part, sans bloquer la première leçon.

Thierry : Bien vu. Et le projet final, c'est Apple en bourse ?

Sylvie : Oui. Le dernier notebook trace le cours de clôture d'Apple avec des moyennes mobiles exponentielles sur 12, 26, 50, 100 et 200 jours. Une EMA, c'est une ligne lissée qui suit le prix : les courtes collent à la courbe, les longues traînent derrière.

Thierry : Du coup, on réutilise tout : une requête, un tableau, des colonnes calculées, un graphique légendé.

Sylvie : Exactement. Et le graphique devient un support de questions concrètes. Les dates sont-elles triées ? Pourquoi une moyenne longue réagit-elle plus lentement ? Toutes les courbes partent-elles des mêmes observations ?

Thierry : Ce sont de bonnes questions de classe. Et avec les dossiers numérotés, on peut revenir sur une notion sans tout refaire.

Sylvie : Voilà. Si pandas est flou, on retourne dans ce dossier, puis on repart.

Thierry : Et après le graphique ?

Sylvie : Antoine propose une suite naturelle avec son projet BatchBacktesting : la même idée d'indicateur, mais sur plusieurs instruments, avec les hypothèses conservées pour pouvoir comparer les résultats.

Thierry : On comprend d'abord un graphique, puis on passe à l'échelle.

Sylvie : C'est ça. Quand chaque notion a sa place, un débutant finit par lire de vraies données et du vrai code. L'article complet a le schéma du parcours et les liens vers chaque notebook.

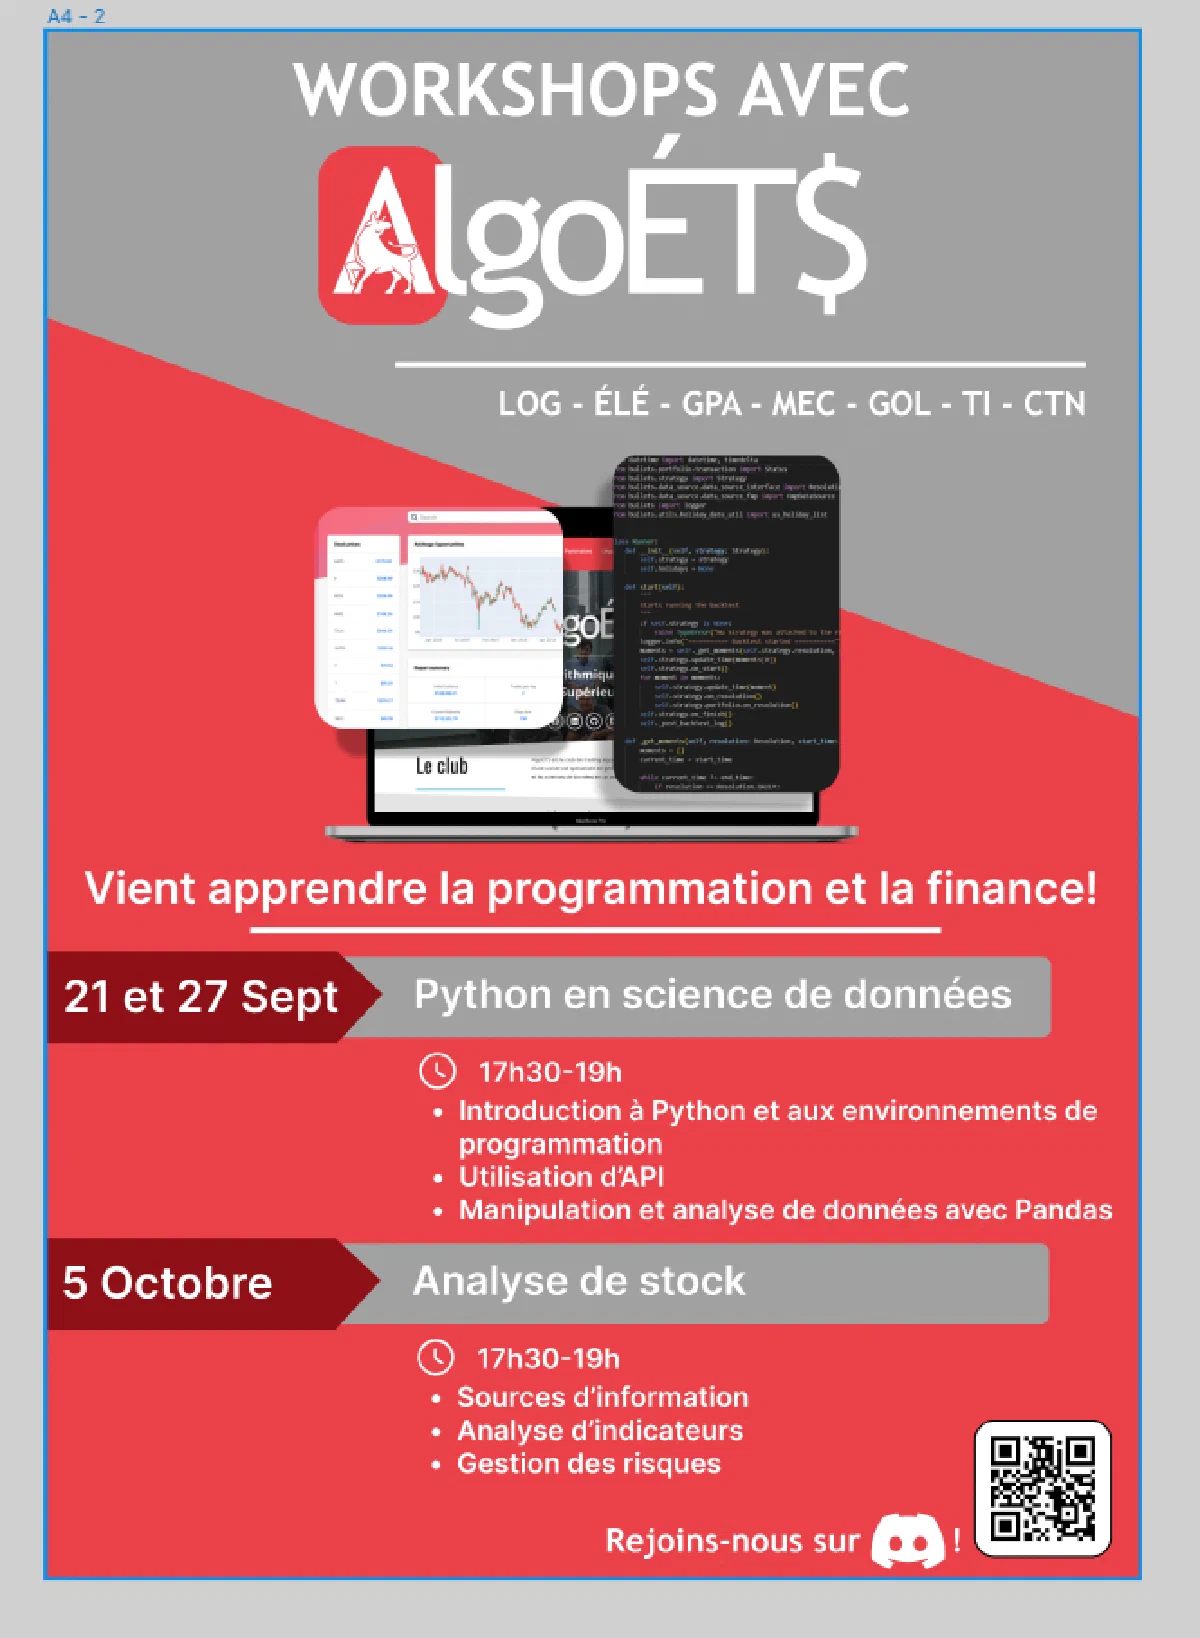
Visuel AlgoETS utilisé dans le dépôt de l’atelier
Table des matières

Un atelier débutant devient plus utile lorsque chaque notion sert à construire la suivante. AlgoETS/Workshop1 passe de l’environnement Python à une réponse API, puis à un DataFrame et à un graphique. Le dernier notebook rassemble ces étapes avec le cours d’Apple et des moyennes mobiles exponentielles.

1. Neuf notebooks, six étapes

Le dépôt contient neuf notebooks Jupyter dans six dossiers numérotés : deux pour l’environnement, deux pour Python, un pour les API, un pour pandas, deux pour la visualisation et un projet final.

Ce chiffre décrit le contenu du dépôt. Il ne mesure ni la participation ni la réussite des étudiants.

flowchart TD
  S["Environnement et notebooks cloud"] --> P["Bases et notions avancées de Python"]
  P --> A["Lire les réponses API"]
  A --> D["Explorer et nettoyer avec pandas"]
  D --> V["Visualiser les données"]
  V --> E["Cours d’Apple et moyennes EMA"]

2. Ne pas laisser l’installation prendre toute la place

Le README propose un point d’entrée Colab[1] et une installation Jupyter locale. Les deux chemins permettent de commencer à coder tout en gardant la configuration comme sujet distinct.

Les dossiers numérotés aident aussi à revenir sur une notion sans recommencer le projet complet.

3. Un exercice final précis

Le code de 5.1_project_ema.ipynb[2] trace le cours de clôture d’Apple et des EMA de 12, 26, 50, 100 et 200 jours. C’est plus précis que la description générale d’exploration et de modélisation du README.

L’exercice relie requête, tableau, colonnes calculées et graphique légendé. Il ne démontre pas la rentabilité d’un croisement de courbes.

4. Lire le graphique comme un exercice de données

Les bonnes questions sont d’abord techniques : les dates sont-elles triées ? Les valeurs manquantes ont-elles été traitées volontairement ? Pourquoi une EMA longue réagit-elle plus lentement ? Toutes les courbes utilisent-elles les mêmes observations ?

Les API, les clés et les versions de bibliothèques peuvent avoir évolué depuis l’atelier. Les notebooks sont du matériel à lire et à adapter, pas la garantie d’un environnement immédiatement reproductible.

5. Passer du graphique au traitement par lots

BatchBacktesting prolonge cette démarche : reprendre les indicateurs, les comparer sur plusieurs instruments et conserver les hypothèses de simulation.

Cette progression permet de comprendre les données et le code avant de tirer des conclusions d’un classement.

6. Sources

Références

  1. point d’entrée Colab. (). [Web page] colab.research.google.com.
  2. AlgoETS. (). 5.1_project_ema.ipynb. [Source file or documentation] github.com.
  3. AlgoETS. (). Workshop1. [Software repository] github.com.
  4. AlgoETS. (). Notebook des bases Python. [Source file or documentation] github.com.

Les références utilisent la date de publication de cet article.